Image Generator
מניפסט אחד, שרשרת סקריפטים, ותיקיית תמונות שמוכנה להיכנס לדמו.
#img-key
החיבור
היצירה רצה מול Gemini דרך מפתח API של גוגל. הסקריפט מחפש אותו לפי הסדר: משתנה סביבה GEMINI_API_KEY, ואז .env.local, ואז .env. בקבצים יכולים להיות שני מפתחות, GEMINI_API_KEY_A ו-GEMINI_API_KEY_B: כשנגמר הקרדיט של A הסקריפט עובר ל-B ומדפיס את זה. אין מפתח, אין יצירה: שאר הסקריפטים בשרשרת עובדים על קבצים מקומיים ולא נוגעים ברשת.
יחסי גובה-רוחב נתמכים: 1:1 · 3:2 · 2:3 · 3:4 · 4:3 · 4:5 · 5:4 · 9:16 · 16:9 · 21:9. גדלים: 512px · 1K · 2K · 4K. ברירת המחדל בדמואים היא 2K, כי יש מרווח לחתוך ממנו, ומיד אחרי זה מקטינים.
אפשר גם פרומפט בודד בלי מניפסט: node scripts/gen-images.mjs --prompt "…" --out path/to/file --ratio 16:9
#img-pipeline
השרשרת
לא כל דמו צריך את כולם: 01 ו-05 תמיד, 02 כמעט תמיד, 03 לפי הסלוט, ו-04 רק כשצריך דמות גזורה.
All in one
scripts/images.mjsכל הצינור בפקודה אחת, על מניפסט אחד: מייצר את מה שחסר, חותך ליחס (פריט עם fit), מקטין (פריט עם width), וגוזר לאובייקט שקוף (פריט עם cutout, או defaults.cutout למניפסט של האובייקטים) ומוחק את ה-JPG ואת התצוגה המקדימה. השלבים למטה נשארים סקריפטים בפני עצמם; זה רק מריץ אותם בסדר.
npm run images -- scripts/prompts/tree-pages.json --only organic--only <substr> · --force
Generate
scripts/gen-images.mjsקורא מניפסט JSON ומייצר את כל התמונות שבו מול Gemini. זה הצעד היחיד שעולה כסף.
node scripts/gen-images.mjs app/demos/<demo>/images/by_ai/manifest.json--only <substr> · --limit N · --force · --dry · --model <id>
Trim
scripts/trim-margins.cjsחותך את האוויר שהמודל אפה לתוך הקובץ. כל מודל מוסיף שוליים, גם כשאומרים לו לא.
node scripts/trim-margins.cjs <in> [out] [pad=24] [tolerance=14]ארגומנטים לפי מיקום, לא דגלים. בלי out כותב על הקובץ עצמו. קובע את תיבת התוכן לפי צבע הפינות ומוריד את כל השאר, ומחזיר pad פיקסלים מכל צד.
Fit
scripts/fit-ratio.cjsחותך ליחס שהסלוט באמת מרנדר. שימושי כשביקשת 16:9 וקיבלת משהו אחר, או כשהסלוט השתנה.
node scripts/fit-ratio.cjs <in> 16:9 [pad] [padY] [out]חיתוך, לא מתיחה. הנושא נשאר בפרופורציה.
Cut out
scripts/cutout.cjsדמות גזורה עם אלפא, לרינדור שנעשה על קנבס אחיד. יוצא WebP שקוף.
node scripts/cutout.cjs <in> <out.webp> 205קנבס כהה → auto:30, אחרת נשארת הילה בשיער.
Shrink
scripts/shrink-images.cjsמשנה גודל ודוחס לפני שהתמונות נכנסות לקוד. בלי זה תיקייה טיפוסית היא 40 מגה ופלוס, וכל בדיקת מובייל היא בדיקה של עמוד 40 מגה. אבל לא להגזים: ברירת המחדל היא 2560 לרחבה, 1800 ל-4:3, 1400 לעומדת, באיכות 82. לא מקשיבים כאן לגוגל: תמונה של 900 במקום של 250 זה בסדר, ושיוריד על זה ציון. התמונה עולה כסף לרנדר, ומסך 1920, זום בדפדפן ושימוש חוזר במקום גדול יותר צריכים את הפיקסלים. תמונה שכבר הוקטנה לא גדלה בחזרה, אז לא מריצים שוב על תיקייה שכבר עברה.
npm run shrink -- app/demos/<demo>/images/by_ai--width N · --map name=W,… · --quality N · --dry · --force
AVIF
scripts/to-avif.cjsאותם פיקסלים, חצי מהבייטים: .avif ליד כל .jpg, באותן מידות. ה-JPG נשאר לתמונת השיתוף (pageMeta מחליף .avif ל-.jpg ב-og:image). הדאטה מצביע על ה-.avif.
npm run avif -- public/build-website--quality 60 · --effort 4 · --dry · --force
#img-manifest
המניפסט
הקובץ יושב ליד התמונות שהוא מייצר, בדרך כלל app/demos/<demo>/images/by_ai/manifest.json. הוא גם התיעוד: הוא נשאר בריפו ואומר איך כל קובץ נוצר, אז כשתמונה מוחלפת מעדכנים בו את הפרומפט שבאמת ייצר את מה שמשוגר. file בלי סיומת, הסיומת נקבעת מה-mime שחוזר. קובץ שכבר קיים מדולג אלא אם --force.
{
  "outDir": ".",                       // relative to THIS file
  "defaults": {
    "model": "gemini-3.1-flash-image",
    "ratio": "4:3",
    "size":  "2K",
    "style": "shared prefix prepended to every item's prompt…"
  },
  "items": [
    { "file": "hero", "ratio": "4:5", "prompt": "…" },
    { "file": "portrait", "style": false, "prompt": "…own style block inline…" },
    { "file": "hero-wire", "ref": "hero", "prompt": "the same page, as a wireframe…" }
  ]
}
כל שדה בפריט (ratio · size · model) דורס את ה-defaults לאותו פריט בלבד. ref מצביע על תמונה אחרת באותה תיקייה ושולח אותה יחד עם הפרומפט, ראו למטה.
#img-internals
מה קורה בפנים
אין כאן SDK ואין קסם: הסקריפט שולח בקשת HTTP רגילה (fetch) ל-API של Gemini, מקבל JSON שהתמונה יושבת בתוכו כטקסט base64, וכותב אותה לדיסק. כל ההרצה בחמישה צעדים:
קורא את המניפסט
מפענח את ה-JSON, ממזג defaults עם ברירות המחדל של הסקריפט (1:1, 1K), ומסנן לפי --only / --limit. outDir נפתר יחסית לקובץ המניפסט.
מרכיב פרומפט לכל פריט
פסקת ה-style, שורה ריקה, ואז ה-prompt של הפריט. style:false מדלג על הפסקה המשותפת, ומחרוזת style על פריט מחליפה אותה. זה כל הסוד של סדרה אחידה: אותו טקסט בתחילת כל בקשה. --dry מדפיס את הפרומפטים המלאים בלי לשלוח כלום.
const style = it.style === false ? '' : (it.style ?? d.style);
const prompt = style ? `${style}\n\n${it.prompt}` : it.prompt;שולח בקשה לגוגל
POST רגיל. שם המודל בכתובת, המפתח בכותרת (ככה גוגל יודע את מי לחייב), ובגוף: הטקסט, בקשה להחזיר תמונה, והיחס והגודל. שתי בקשות רצות במקביל.
POST https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-flash-image:generateContent
x-goog-api-key: $GEMINI_API_KEY

{
  "contents": [{ "parts": [{ "text": "<style>\n\n<prompt>" }] }],
  "generationConfig": {
    "responseModalities": ["IMAGE"],
    "imageConfig": { "aspectRatio": "1:1", "imageSize": "1K" }
  }
}מקבל JSON עם התמונה בתוכו
התמונה חוזרת כמחרוזת base64 ארוכה. הסקריפט הופך אותה חזרה לבייטים, קובע סיומת לפי ה-mimeType, וכותב את הקובץ. קובץ שכבר קיים מדולג לפני שנשלחת בקשה, אז הרצה חוזרת לא עולה כסף.
{ "candidates": [{ "content": { "parts": [
  { "inlineData": { "mimeType": "image/jpeg", "data": "/9j/4AAQSkZJRg…" } }
]}}]}

Buffer.from(part.inlineData.data, 'base64') → step-1-brief.jpgניסיון חוזר, רק כשיש טעם
עומס (429, 500, 503) או תשובה בלי תמונה: מחכה 3, 6, 12 שניות ומנסה שוב. שגיאת חיוב (נגמר הקרדיט, free tier) עוצרת מיד, כי ניסיון חוזר רק שורף זמן. בסוף: כמה נוצרו, כמה דולגו, כמה נכשלו.
Gemini לא זוכר את התמונה הקודמת
כל פריט הוא בקשה נפרדת לגמרי, כמו צ'אט חדש. סדרה נראית אחידה רק כי כל הבקשות מתחילות באותה פסקת style בדיוק. לכן הפסקה נותנת קודי hex ולא "כחול": מילה משאירה למודל לפרש, קוד כמעט לא. הדרך היחידה לתת לו לראות תמונה קיימת היא ref.
#img-example
דוגמה: איורי התהליך
ארבעת האיורים של סקשן התהליך בדף הבית נוצרו מהקובץ public/uikit/process/manifest.json. ארבע בקשות נפרדות, ואותה שפה בכולן:
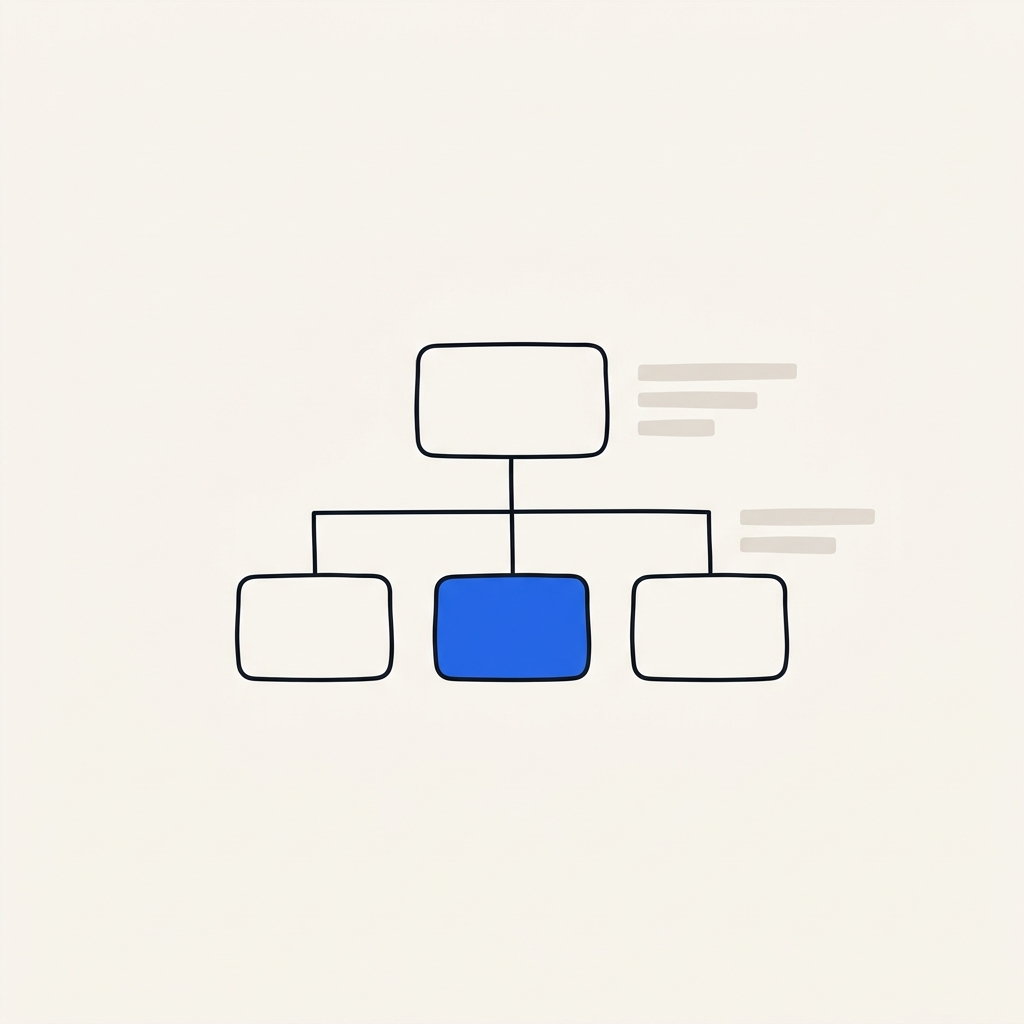
זה הפרומפט שנשלח בפועל עבור step-1-brief. הפסקה הראשונה זהה בכל ארבע הבקשות, השנייה היא הפריט:
── defaults.style (same in all four) ─────────────────────────
A set of four matching flat vector illustrations for a web studio's
process diagram. Shared rules for all four: a single warm off-white
background (#faf7f3) filling the whole square edge to edge, with NO
border, NO frame and NO drop shadow anywhere. One simple centred
subject, drawn as clean geometric shapes with thin confident outlines,
in a restricted palette of near-black (#1a1a1a), cobalt blue (#2563eb),
soft violet (#8b5cf6) and light warm grey. ABSOLUTELY NO readable text…
nothing at all in the corners, because the image will be cropped to a
circle. Calm, modern, uncluttered, editorial.

── items[0].prompt (this picture only) ────────────────────────
A small hand-drawn style site map: one rounded rectangle at the top and
three smaller rectangles below it, joined by thin straight connector
lines. One of the lower rectangles is filled cobalt blue, the rest are
outlined only. Two or three short grey placeholder bars float beside
the diagram to suggest notes.
מה מגיע מה-style
הרקע הקרם, הכחול והסגול, הקו השחור הדק, הפשטות, היעדר הטקסט, והנושא שיושב באמצע עם פינות ריקות (כי הסלוט חותך לעיגול). כל מה שהופך את ארבעתם לסדרה.
מה מגיע מה-prompt
רק מה מצויר: מפת אתר, לוח עיצוב, בלוקים שמורכבים, חלון דפדפן עם וי. הפרומפט של step-2-look מתגונן במיוחד ("ONE single illustration, never four panels") כי המילים "a set of four" ב-style גרמו למודל לצייר ארבעה איורים בפריים אחד.
#img-add
להוסיף תמונה לדמו קיים
המניפסט הוא גם ההיסטוריה: כל פריט הוא קובץ שקיים בתיקייה, והפרומפט שייצר אותו כתוב לידו. תמונה חדשה היא פריט חדש, והיא יורשת את ה-style של הדמו אז היא תתאים לשאר.
# 1. add one item to items[] in the demo's manifest
{ "file": "class-boxing", "ratio": "4:3", "prompt": "A boxing class: two heavy bags…" }

# 2. see the exact prompt that will be sent (free, no request)
node scripts/gen-images.mjs app/demos/gym_24_09/images/by_ai/manifest.json --only class-boxing --dry

# 3. generate just that one (the 17 existing files are skipped anyway)
node scripts/gen-images.mjs app/demos/gym_24_09/images/by_ai/manifest.json --only class-boxing

# 4. trim + shrink, then commit the manifest AND the picture together
node scripts/trim-margins.cjs app/demos/gym_24_09/images/by_ai/class-boxing.jpg
npm run shrink -- app/demos/gym_24_09/images/by_ai
לא אהבת? לשנות את הפרומפט במניפסט ולהריץ שוב עם --force. אותו פרומפט פעמיים נותן תמונה דומה, לא זהה: המניפסט שומר את המתכון, git שומר את התוצאה.
#img-ref
ref: לתת למודל לראות
כשהסדרה חייבת להיות צמודה יותר ממה שטקסט נותן (אותו עמוד כאתר וכ-wireframe, אותה דמות בשתי תנוחות), פריט מקבל "ref": "other-file". הסקריפט קורא את הקובץ, מקודד אותו ל-base64 ושולח אותו כחלק ראשון בבקשה, לפני הטקסט. המודל מצייר מחדש את מה שהוא רואה במקום להתחיל מדף ריק. את תמונת ה-ref מייצרים קודם (--only), ואז את הפריט.
contents: [{ parts: [
  { inlineData: { mimeType: 'image/jpeg', data: '<hero.jpg as base64>' } },   // what it sees
  { text: '<style>\n\n<prompt>' },                                          // what to do with it
]}]#img-vr
דוגמה: אתר למשקפי VR, צילום ריאליסטי
הדוגמה הקודמת היא איור וקטורי. זו מראה את הצד השני: תמונות שצריכות להיראות כמו צילום אמיתי, hero ועוד ארבע באותו סגנון ועם אותו מוצר. המניפסט הוא קובץ אמיתי שמוכן להרצה, public/uikit/examples/vr/manifest.json, והסקשן הזה נבנה ממנו.
מה הופך פרומפט לצילום
המדיום: צילום, לא רינדור
Photorealistic commercial photograph… shot on a full-frame cameraהמילה הראשונה קובעת את הז׳אנר. "render", "3D" או "futuristic" מושכים את המודל ל-CGI מבריק, גם אם כתוב photorealistic אחר כך.
מצלמה ועדשה
85mm lens at eye level, f/2.8 · 35mm, candid · 100mm macroמונחי צילום אמיתיים מביאים את מה שבא איתם: עומק שדה, פרספקטיבה, דחיסה. זה גם מה שמותר לשנות בין תמונה לתמונה.
אור מוגדר
soft large-source daylight or a big softbox from one side… no neon, no glow, no lens flareאור בלי מקור נראה כמו רינדור. אור מצד אחד עם דעיכה טבעית נראה כמו חדר אמיתי. ובלי ניאון, שהוא הקלישאה של VR.
חומרים עם טקסטורה
fine texture on the matte plastic, visible weave in the fabric, faint real-world reflectionsמשטח חלק לגמרי הוא הסימן הכי בולט לתמונה מלאכותית. לבקש את הפגמים הקטנים שיש לחפץ אמיתי.
אנשים אמיתיים
natural skin with visible pores and texture… never posed like stockבלי זה העור יוצא חלק כמו פלסטיק והחיוך כמו תמונת סטוק.
מה לא
NOT a 3D render, NOT CGI, NOT an illustration, no plastic-looking skinשלילה מפורשת של מה שהמודל נוטה אליו בנושא טכנולוגי. בלי שורה כזו, VR מושך אותו לסגנון מד״ב.
איך ארבע התמונות הבאות נשארות באותו סגנון
המוצר מוגדר פעם אחת, ב-style
צבע המעטפת, הרצועה עם קוד hex, הריפוד, שתי המצלמות. כל תמונה מקבלת את אותו תיאור, אז כולן מציירות את אותו מכשיר ולא חמישה מכשירים דומים.
ref לתמונת ה-hero
ארבעת הפריטים שאחרי מקבלים "ref": "vr-headset-on-oak-table" ואת המשפט The SAME headset from the reference picture. המודל רואה את המכשיר שכבר נוצר ומצייר אותו שוב. זו הסיבה שה-hero נוצר קודם, לבד.
בין תמונות משתנה רק המצלמה
עדשה, חיתוך, זווית והסצנה. האור, הפלטה והחומרים נשארים ב-style ולא נכתבים מחדש בפריט, כדי שלא יסתרו אותו.
חמש התמונות
vr-headset-on-oak-table16:9woman-using-vr-headset-living-room4:3ref: vr-headset-on-oak-tablevr-headset-lenses-close-up1:1ref: vr-headset-on-oak-tablehands-adjusting-vr-headset-strap3:2ref: vr-headset-on-oak-tablevr-headset-controllers-box-flat-lay4:5ref: vr-headset-on-oak-tableלהריץ
# 1. the hero alone: the other four send it as their ref, so it must exist first
node scripts/gen-images.mjs public/uikit/examples/vr/manifest.json --only vr-headset-on-oak-table

# 2. look at it. Wrong headset? change the product lines in style, --force, repeat.
#    Only once the hero is right:
node scripts/gen-images.mjs public/uikit/examples/vr/manifest.json

# 3. as always
npm run shrink -- public/uikit/examples/vr
בלי צעד 1 לבד, שתי הבקשות הראשונות יוצאות במקביל והפריט השני מחפש את ה-hero לפני שהוא קיים. כשהתמונות נוצרות הן מופיעות בסלוטים למעלה בלי לגעת בקוד.
המניפסט המלא
{
  "outDir": ".",
  "defaults": {
    "model": "gemini-3.1-flash-image",
    "ratio": "4:3",
    "size": "2K",
    "style": "Photorealistic commercial photograph for the website of a consumer VR headset brand, shot on a full-frame camera. THE PRODUCT, identical in every picture: a compact standalone VR headset with a smooth matte white front shell, softly rounded edges, a thin charcoal-grey fabric face cushion, a soft woven strap in muted lavender (#b8a9d9), and two small dark camera lenses on the front. No logo, no text, no brand mark anywhere on it. LIGHT: soft large-source daylight or a big softbox from one side, gentle natural falloff, true-to-life colour, no neon, no glow, no lens flare. MATERIALS read as real: fine texture on the matte plastic, visible weave in the fabric, faint real-world reflections. PALETTE of the world around it: warm white, pale oak, stone grey, a touch of lavender. Shallow depth of field, crisp focus on the subject, subtle film grain. People, when present, have natural skin with visible pores and texture, relaxed real expressions, never posed like stock. NOT a 3D render, NOT CGI, NOT an illustration, no plastic-looking skin, no futuristic sci-fi styling, no text, no logos, no watermarks."
  },
  "items": [
    {
      "file": "vr-headset-on-oak-table",
      "ratio": "16:9",
      "prompt": "Hero product shot: the headset resting at a slight three-quarter angle on a pale oak table, strap curving behind it, a warm white wall softly out of focus behind. Morning daylight from a window on the left, 85mm lens at eye level with the product, f/2.8. The headset sits in the right third of the frame, empty calm space on the left."
    },
    {
      "ref": "vr-headset-on-oak-table",
      "file": "woman-using-vr-headset-living-room",
      "prompt": "The SAME headset from the reference picture, now worn by a woman in her early thirties sitting cross-legged on a light linen sofa in a bright living room, hands raised mid-gesture as if touching something in front of her, a slight smile below the headset. Soft afternoon daylight, plants and pale wood in the soft background. 35mm lens, candid, as if photographed by a friend."
    },
    {
      "ref": "vr-headset-on-oak-table",
      "file": "vr-headset-lenses-close-up",
      "ratio": "1:1",
      "prompt": "The SAME headset from the reference picture, macro close-up from the inside: the two round lenses and the charcoal fabric face cushion, fine weave visible, a soft reflection of a window in the lens glass. 100mm macro lens, very shallow depth of field, the nearer lens tack sharp."
    },
    {
      "ref": "vr-headset-on-oak-table",
      "file": "hands-adjusting-vr-headset-strap",
      "ratio": "3:2",
      "prompt": "The SAME headset from the reference picture held in two hands at chest height, one thumb adjusting the lavender strap. Crop from the collarbone down to the hands, a plain oatmeal knit sweater, no face in frame. Side light from a window, 50mm lens, shallow depth of field."
    },
    {
      "ref": "vr-headset-on-oak-table",
      "file": "vr-headset-controllers-box-flat-lay",
      "ratio": "4:5",
      "prompt": "Straight-down flat lay on a pale stone surface: the SAME headset from the reference picture beside its two small white controllers, a coiled charging cable and an open plain white box with a lavender inner tray. Everything neatly aligned with even gaps, soft shadowless overhead light, the arrangement filling the frame edge to edge."
    }
  ]
}#img-cases
מה קורה כשמבקשים
שלוש בקשות שחוזרות, וכל הצעדים שהסוכן עושה בכל אחת. המנגנון מוסבר למעלה, כאן רק המסלול.
הבקשה
"תוסיף עוד צלחת למסעדה היפנית"
אין כאן כלי מיוחד. זה אותו מניפסט ואותו סקריפט, והעבודה היא בעיקר לקרוא מה כבר קיים ולהמשיך אותו.
- 01
מוצא את הדמו ואת המניפסט שלו. היפנית היא מותג sushi בתוך catania_24_06, והמניפסט יושב ליד התמונות.
app/demos/catania_24_06/images/sushi/manifest.json - 02
מזהה את התבנית. הצלחות הן פריטי cut-plate-*: style:false עם מתכון משלהן (מבט מלמעלה, רקע לבן טהור, צלחת עגולה על 90% מהפריים), וכלל הכשרות חוזר בכל אחד. מעתיק את המבנה, משנה רק את המנה, ונותן שם שמתאר אותה.
{ "file": "cut-plate-uramaki-salmon-avocado", "ratio": "1:1", "size": "1K", "style": false, "prompt": "Photorealistic food photograph shot straight down from directly above: one round matte black ceramic plate, perfectly circular, centred, filling about 90% of the frame. On it: eight pieces of inside-out uramaki, salmon and avocado inside, sesame outside… PURE WHITE seamless background (#ffffff)… Kosher: salmon only, no shellfish, no dairy." } - 03
בודק את הפרומפט המלא בחינם, ואז מייצר רק את הפריט החדש.
node scripts/gen-images.mjs app/demos/catania_24_06/images/sushi/manifest.json --only uramaki --dry node scripts/gen-images.mjs app/demos/catania_24_06/images/sushi/manifest.json --only uramaki - 04
מסתכל על התוצאה, כי הוא רואה תמונות. הצלחת עגולה ושלמה? הרקע לבן? אין שרימפס? אם לא, מתקן את הפרומפט ומריץ שוב עם --force. זה הלופ: לייצר, להסתכל, לתקן, עד שזה נכון, ורק אז להמשיך.
- 05
גוזר את הרקע ל-WebP שקוף, באותו שם בלי ה-cut.
node scripts/cutout.cjs app/demos/catania_24_06/images/sushi/cut-plate-uramaki-salmon-avocado.jpg app/demos/catania_24_06/images/sushi/plate-uramaki-salmon-avocado.webp - 06
מחבר לעמוד. הצלחות הן מערך ב-SushiHome.tsx, אז זה import ועוד שורה.
import plateUramaki from '../images/sushi/plate-uramaki-salmon-avocado.webp'; { dish: 'אורמאקי סלמון אבוקדו', jp: 'サーモンアボカド裏巻き', img: plateUramaki.src }, - 07
מצלם את העמוד בנייד ובמחשב. commit אחד למניפסט, ל-jpg, ל-webp ולקוד, כדי שהמתכון והתוצאה ייכנסו יחד.
הבקשה
"בתמונה של הניגירי יש קערת סויה מיותרת"
שתי דרכים, ולא אותה דרך לכל בעיה.
- 01
דרך א, לייצר מחדש: מוחק את הסויה מהפרומפט במניפסט ומריץ --force. זו תמונה חדשה מאפס. טוב כשהבעיה בכל הקומפוזיציה, אבל גם מה שאהבת ישתנה.
node scripts/gen-images.mjs app/demos/catania_24_06/images/sushi/manifest.json --only plates-nigiri --force - 02
דרך ב, לערוך: שולח את התמונה הקיימת כ-ref עם הוראה לשנות רק דבר אחד. המודל מצייר מחדש את מה שהוא רואה, אז השאר נשאר קרוב מאוד. כותב לשם חדש, כדי להשוות לפני שמחליפים.
node scripts/gen-images.mjs --ref app/demos/catania_24_06/images/sushi/plates-nigiri.jpg \ --prompt "The same photograph, keep everything exactly as it is, except: remove the small dish of soy sauce and let the linen napkin fill its place." \ --out app/demos/catania_24_06/images/sushi/plates-nigiri-edit --ratio 4:3 --size 2K - 03
אם העריכה טובה, מחליף את הקובץ, ומעדכן גם את הפרומפט במניפסט כך שיתאר את התמונה המתוקנת. אחרת, הרצה עתידית תחזיר את הסויה. git שומר את הגרסה הקודמת.
חיתוך, בהירות או מיקום בסלוט לא מצריכים לייצר מחדש: זה fit-ratio, object-position או CSS.
הבקשה
"מצרף צילום מסך של תמונה: תעשה משהו כזה"
Claude רואה את הצילום, אבל Gemini לא. Gemini רואה רק מה שנשלח אליו בבקשה, ויש שתי דרכים להעביר אליו את הצילום.
- 01
דרך א, לתרגם למילים (ברירת המחדל): Claude מפרק את הצילום לאותן שכבות מדוגמת ה-VR: סוג הצילום, עדשה וזווית, מאיפה האור, פלטה עם קודי צבע משוערים, חומרים, קומפוזיציה. הסוד הוא הדיוק: "אור חלון רך משמאל, 50mm, מעט מלמעלה, קרם וטרקוטה #c96f4a" ולא "תמונה חמה ויפה". יוצא אותו מצב רוח, לא העתק.
"style": "Photorealistic editorial food photograph. Soft window light from the left, gentle falloff, 50mm lens slightly above the table. Palette: cream, terracotta (#c96f4a), pale linen. Matte ceramics, visible bread crumb texture, shallow depth of field…" - 02
דרך ב, הצילום עצמו כ-ref: צריך אותו כקובץ בדיסק. תמונה שהודבקה בצ׳אט היא לא קובץ שהסקריפט יכול לקרוא, אז שומרים אותה בפרויקט, ב-_refs/ שבשורש, שנמצא ב-.gitignore. התוצאה קרובה מאוד לקומפוזיציה של המקור.
node scripts/gen-images.mjs --ref _refs/inspiration.jpg \ --prompt "A new photograph in the same light, angle and palette as the reference, but the subject is …" --out app/demos/catania_24_06/images/sushi/… --ratio 4:3 - 03
בדרך כלל משלבים: המילים מדרך א נותנות את הסגנון, ו-ref רק כשהקומפוזיציה חייבת להיות זהה. וכדאי לצלם רק את התמונה, בלי ממשק האתר מסביב, אחרת גם הוא נכנס לתיאור.
השראה, לא העתקה: צילום של מישהו אחר הוא רפרנס לסגנון. לשחזר אותו אחד לאחד זו כבר בעיה של זכויות יוצרים.
#img-rules
הכללים שנשברים
אלה לא העדפות. כל אחד מהם הגיע מתמונה ששוגרה ושברה עימוד, והם כתובים גם בסקיל של בניית הדמואים.
בלי שוליים בתוך הקובץ
הרווח סביב תמונה הוא החלטה של העימוד, לא של הקובץ. שוליים אפויים מתווספים על הרווח שב-CSS, לא מתכווצים במובייל, ושוברים object-fit ו-aspect-ratio. למדוד את תיבת התוכן, ומעל 5% בצד זה באג.
חריג אחד: SAFE ZONE
תמונה שנוחתת בסלוט שחותך אותה (cover, תא בבנטו, עיגול) צריכה לשמור את הנושא בתוך 74% האמצעיים. זה נדרש בפרומפט, לסלוט הזה בלבד. שוליים זה אוויר שהעימוד חי איתו; SAFE ZONE זה אוויר שהעימוד אוכל.
בלי צל אפוי
עומק שייך ל-CSS. צל מוטל בתוך התמונה נועל אותך לזווית ולצבע רקע אחד.
להתאים לקרקע
איור שנוצר על רקע אפור בתוך ממשק לבן נראה כמו טעות. לבקש pure white background במפורש לכל מה שיושב על לבן.
כלל טקסט נוקשה
המודל מצייר קודי צבע, מספור ותוויות אם נותנים לו פתח. בלוק הסטייל אומר במפורש: בלי טקסט, בלי אותיות, בלי מספרים, בלי לוגואים ובלי שמות מותג על שום בקבוק או מכשיר.
שם קובץ סמנטי, בשביל SEO
שם הקובץ נקרא על ידי גוגל ומופיע בחיפוש תמונות. file במניפסט הוא שם הקובץ שיוצא לאוויר, אז הוא מתאר מה רואים: vr-headset-on-oak-table, לא image-01 ולא hero. אותיות קטנות, מקפים, באנגלית, בלי מספרים רצים. אותו שם עובר גם לקובץ הגזור (cut-plate-x ← plate-x).
תמונה לא מוכנה עד שהיא הוקטנה
הקבצים חוזרים ב-2K ובמשקל מגות. צעד 05 הוא חלק מהיצירה, לא אופטימיזציה שעושים אחר כך.
#img-traps
מלכודות
outDir הוא יחסי לקובץ המניפסט
לא ל-cwd. מניפסט זמני ב-scripts/ עם outDir של "../../app/demos/…" יכתוב רמה אחת מעל שורש הפרויקט, בלי שום שגיאה.
sharp נכשל בכתיבה חזרה לאותו נתיב
בווינדוס sharp פותח את הקובץ בעצלתיים, אז כתיבה לנתיב שקראת ממנו נכשלת עם UNKNOWN. לקרוא ל-Buffer קודם, ואז להעביר את ה-buffer ל-sharp.
מחרוזת style על פריט התעלמה עד 31.10
עד 31.10 gen-images כיבד רק style:false, ומחרוזת style על פריט פשוט התעלמה. עכשיו היא מחליפה את הפרומפט המשותף, אז --force על מניפסט ישן עשוי להוציא תמונה אחרת.
המודל מחזיר דיפטיך
בריף של "לפני ואחרי" מחזיר שתי פנים בפריים אחד. צריך משפט מפורש: exactly ONE face, never a split image, never two panels.